
أخبار
فهم البحث عن تشابه المتجهات وكيفية عمله
هل تساءلت يومًا كيف يُدرك تطبيقك المفضل ما تبحث عنه، حتى لو لم تكتبه بدقة؟ عندما تبحث عن صورة أو أغنية أو منتج يُشبه شيئًا أعجبك سابقًا، فغالبًا ما يكون ذلك بفضل بحث تشابه المتجهات الذي يعمل بهدوء خلف الكواليس. إنه لا يُطابق الكلمات أو أسماء الملفات، بل يُميز الأنماط - العلاقات الخفية في الأرقام والأشكال ونقاط البيانات التي تربط بين الأشياء بطرق خفية.
تُشغّل هذه التقنية كل شيء، من أنظمة التوصية إلى روبوتات الدردشة الذكية. ولكن ما الذي يحدث فعليًا؟ كيف تُدرك أجهزة الكمبيوتر معنى "متشابه" في حال عدم وجود تطابقات دقيقة؟ لنُفصّل الأمر ببساطة ونرى كيف يعمل في الواقع.
ما هو البحث عن تشابه المتجهات؟
في جوهره، يساعد البحث عن تشابه المتجهات في العثور على عناصر قريبة رياضيًا مما تبحث عنه. فبدلًا من مطابقة الكلمات أو التسميات بدقة، يبحث عن علاقات بناءً على أنماط في البيانات نفسها. بهذه الطريقة، يستطيع النظام التعرّف على صورة تُشبه صورة أخرى، أو اقتراح أغانٍ تُناسب ذوقك، أو عرض مستند يُشير إلى نفس معنى استعلامك.
إليكم الصورة الكاملة. أولًا، تُحوَّل بياناتك الخام، سواءً كانت نصًا أو صورة أو حتى نقرة، إلى متجه، وهو ببساطة قائمة أرقام تُمثل أهم خصائصها. ثم، عند البحث، يُحوَّل استعلامك إلى متجه آخر. وأخيرًا، يُقارن النظام متجهك بملايين المتجهات الأخرى، ويبحث عن المتجه الأقرب إلى بعضها. كلما كان المتجه أقرب، ازداد تشابهه. فكرة بسيطة، لكنها فعّالة بشكل مدهش.
إذن، ما هو المتجه على أية حال؟
المتجه في الواقع مجرد قائمة أرقام. ولكن في هذه الحالة، تُجسّد هذه الأرقام جوهر الشيء - معناه، أسلوبه، أو خصائصه - عبر أبعاد متعددة. قد تصبح الجملة متجهًا بـ 768 بُعدًا (إذا كنت تستخدم نموذجًا مثل BERT). قد تكون الصورة بـ 512 بُعدًا. يُساعد كل رقم في وصف جزء صغير مما يجعل هذا الشيء فريدًا.
جميع هذه المتجهات تعيش فيما يُسمى فضاءً عالي الأبعاد. عندما نقارن عنصرين، فإننا نتساءل: ما المسافة بينهما في ذلك الفضاء؟ كلما اقتربت إحداثياتهما، زاد تشابههما.
كل شيء يبدأ بالتضمينات
قبل إجراء المقارنة، يجب تحويل البيانات إلى تلك المتجهات - وهي عملية تُسمى التضمين. تتعامل النماذج المختلفة مع أنواع بيانات مختلفة. تتم معالجة النص بواسطة نماذج مثل Word2Vec وGloVe وBERT. تمر الصور عبر الشبكات العصبية التلافيفية (CNNs). قد تستخدم البيانات المهيكلة هندسة الميزات أو برامج التشفير التلقائي.
التضمينات الجيدة كالترجمات الجيدة، فهي تُركز على الأهم وتُغفل ما لا يُهم. عندما يكون عنصران متشابهين تمامًا، فإن تضميناتهما تتقارب. هذا هو سرّ الفكرة.
كيف نبني حول البحث عن المتجهات
في موبيان, نعمل مع شركات لا تقتصر تعاملاتها على البيانات المتنامية فحسب، بل تشمل أيضًا تعقيدات متزايدة. سواءً في مجال الرعاية الصحية، أو التمويل، أو الاتصالات، أو الخدمات اللوجستية، فإن الحاجة إلى عرض معلومات ذات صلة واعية بالسياق بسرعة تتزايد باستمرار. وهنا يأتي دور البحث عن تشابه المتجهات.
عندما نبني منصات أو نعزز فرق العمل، غالبًا ما نساعد عملاءنا على تجاوز منطق التصفية التقليدي نحو أنظمة تستخدم التضمينات والفهرسة الذكية والمطابقة الفورية. سواء كنا ندمج البحث في منتج SaaS مخصص أو نبني واجهة خلفية مدعومة بالذكاء الاصطناعي من الصفر، فإن البحث المتجهي يساعدنا على خلق تجارب ذكية وسريعة ومخصصة. الأمر لا يقتصر على مطابقة العناصر فحسب، بل يتعلق أيضًا بجعل البيانات مفيدة حقًا - وهذا تحدٍّ نعرف كيف نواجهه.
قياس "القرب"“
لتحديد العناصر المتشابهة، تقيس الأنظمة المسافة بين المتجهات. تختلف مقاييس المسافة باختلاف الغرض:
- المسافة الإقليدية: المسار المستقيم بين نقطتين - بسيط وبديهي.
- تشابه جيب التمام: يُركز على الزاوية بين المتجهات بدلاً من المسافة. مثالي للنصوص.
- تشابه جاكارد: ينظر إلى التداخل بين المجموعات، وهو مفيد للفئات أو العلامات.
- مسافة مانهاتن: قم بإضافة الاختلافات خطوة بخطوة، مثل المشي في كتل المدينة.
- مسافة هامينج: تحسب عدد البتات التي تختلف بين متجهين ثنائيين.
لا توجد طريقة واحدة مثالية؛ فالأمر يعتمد على ما يعنيه "مشابه" لبياناتك.
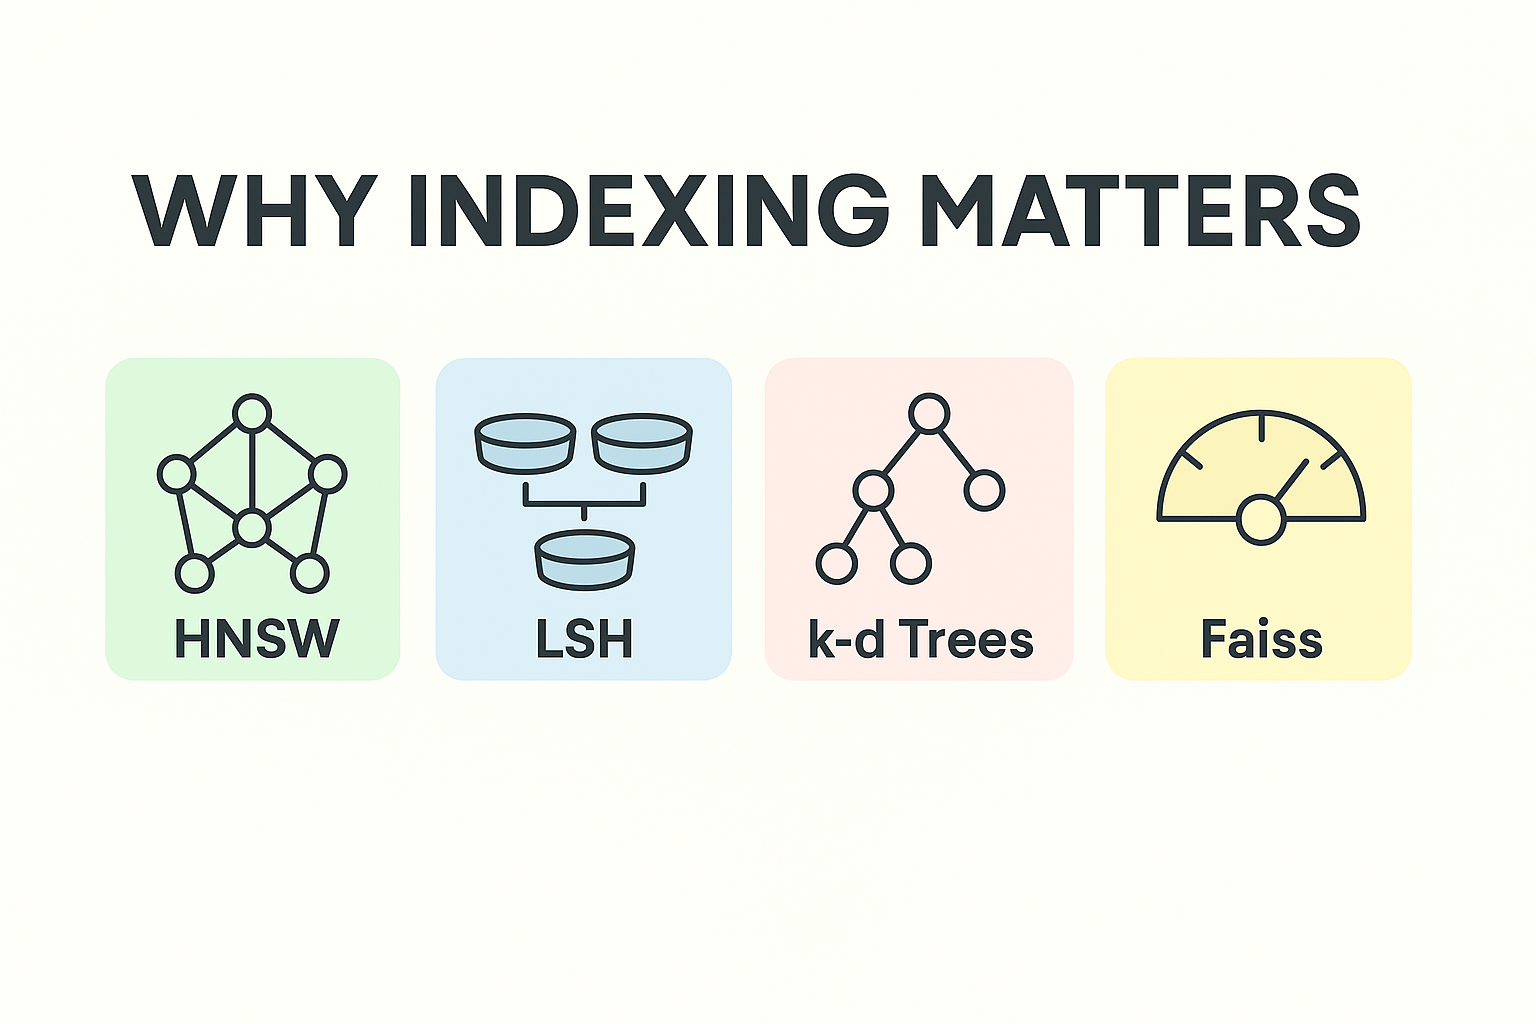
لماذا الفهرسة مهمة
إذا كان لديك بضعة آلاف فقط من المتجهات، فقد يكون من الجيد مقارنتها واحدًا تلو الآخر. ولكن بمجرد وصولك إلى الملايين، ينهار هذا النهج. تساعد الفهرسة على تنظيم المتجهات بحيث لا يضطر البحث إلى التحقق من كل متجه على حدة.
تتضمن بعض طرق الفهرسة الشائعة ما يلي:
- HNSW: رائع للبحث السريع والتقريبي على نطاق واسع
- LSH: تجميع المتجهات المتشابهة في مجموعات للبحث السريع
- أشجار kd وأشجار الكرة: تعمل بشكل جيد مع البيانات ذات الأبعاد الأقل
- Faiss وAnny وVP Trees: مُحسَّنة للسرعة على نطاق واسع
إنهم ليسوا مثاليين دائمًا، لكنهم يقربونك بما يكفي، ويفعلون ذلك بسرعة.
الحصول عليه بشكل صحيح
البحث عن المتجهات ليس مجرد عملية توصيل واكتمال، بل يتطلب تخطيطًا وضبطًا دقيقًا. إليك بعض الأمور المهمة التي يجب مراعاتها:
- تطبيع البيانات: تأكد من أن بياناتك نظيفة ومتسقة قبل التضمين.
- ضبط الخوارزمية: نادرًا ما تعمل الإعدادات الافتراضية في جميع الحالات. اختبرها وعدّلها.
- تخفيض الأبعاد: تؤدي المتجهات عالية الأبعاد إلى إبطاء الأشياء، لذا قم بضغطها بعناية باستخدام أدوات مثل PCA أو أجهزة الترميز التلقائي.
- التجزئة والتوازي: بالنسبة لمجموعات البيانات الضخمة، قم بتقسيمها إلى أجزاء والبحث عبر العقد بالتوازي.
- تسريع الأجهزة: استخدم وحدات معالجة الرسومات (GPU) أو وحدات معالجة الرسومات (TPU) عندما تكون السرعة مهمة حقًا.
الأمر أشبه بالطبخ - لا يمكنك خلط المكونات معًا. التحضير يُحسّن الطبق أو يُفسده.
أين ستشاهده في العمل
ربما استخدمتَ البحث المتجهي دون أن تُدرك ذلك. فهو موجود خلف محركات البحث المرئية التي تعثر على الصور حسب محتواها، لا أسماء الملفات. وهو موجود في توصيات نتفليكس أو سبوتيفاي التي تُفهمك ببساطة. وهو يُعزز كشف الاحتيال من خلال رصد المعاملات التي تبدو غير طبيعية مقارنةً بالسلوكيات السابقة.
حتى روبوتات الدردشة بالذكاء الاصطناعي تعتمد عليها. فبدلاً من مطابقة الكلمات المفتاحية، تستخدم التضمينات لفهم قصدك والرد بمعلومات ذات صلة. والبحث الدلالي - وهو النوع الأذكى الذي يفهم قصدك - مبني على المبدأ نفسه.
المقايضات
يُعدّ البحث عن تشابه المتجهات مفيدًا للغاية، ولكنه ليس خاليًا من المشاكل. كما هو الحال مع أي نظام معقد، هناك بعض التفاصيل التي يجب فهمها قبل البدء.
أولاً، هناك مشكلة الأبعاد العالية. كلما زادت أبعاد متجهاتك، زادت صعوبة تحديد ما هو "قريب" حقًا. في المساحات الشاسعة، تبدأ كل الأشياء بالظهور بمسافات متساوية، مما يجعل التشابه أقل أهمية. يشبه الأمر محاولة تحديد موقع صديقك وسط حشد من الآلاف - اتجاهات كثيرة جدًا للنظر فيها، وفجأة تصبح كلمة "قريب" غير ذات معنى.
ثم هناك التخزين. تشغل المتجهات مساحةً هائلة. عند التعامل مع ملايين نقاط البيانات، كلٌّ منها مُمَثَّل بمئات الأرقام، تتزايد احتياجاتك من التخزين والذاكرة بسرعة. ولا يقتصر الأمر على المتجهات نفسها، بل يتطلب أيضًا الحفاظ على هياكل الفهرسة والرسوم البيانية والبيانات الوصفية لتسريع البحث. كل هذا يُضاف إلى مجموع البيانات.
اختيار المقياس الصحيح قد يُعيقك أيضًا. تشابه جيب التمام، والمسافة الإقليدية، وجاكارد، كلٌّ منها يقيس "القرب" بشكل مختلف قليلًا. اختيار المقياس الخاطئ قد يُعطي نتائج خاطئة تمامًا. أحيانًا، لا يتعلق الأمر بالنظريات بقدر ما يتعلق باختبار أي طريقة تُناسب بياناتك تحديدًا.
وبالطبع، هناك قيم شاذة - نقاط بيانات غريبة لا تتوافق مع النمط. بعض المتجهات الغريبة ذات القيم المتطرفة قد تُفسد نتائجك، مما يدفع بحثك نحو نتائج غير ذات صلة. إذا لم تُعالجها بشكل صحيح، فقد يبدأ نظامك بأكمله بإظهار نتائج غير صحيحة دون أن تُدرك ذلك.
مع ذلك، لا تُعتبر هذه الأمور عائقًا. إنها ببساطة بعض التنازلات التي تصاحب العمل على نطاق واسع. بمجرد فهم كيفية إدارتها، من خلال تحسين التضمينات والتطبيع والضبط الدقيق، يُصبح البحث عن تشابه المتجهات من أقوى الأدوات في مجموعة أدوات الذكاء الاصطناعي لديك.
أدوات يمكنك تجربتها إذا كنت مستعدًا للاستكشاف
لقد تم إنجاز الكثير من العمل الشاق. لستَ بحاجة إلى بناء محرك بحث متجه خاص بك من الصفر.
المكتبات والأطر
- Faiss (Meta): قوي وسريع وجاهز لوحدة معالجة الرسومات
- Annoy (Spotify): رائع للبحث التقريبي مع مجموعات البيانات الكبيرة
- Milvus: قاعدة بيانات متجهية مفتوحة المصدر مع إمكانية التوسع المضمنة
- Scikit-learn: جيد للنماذج الأولية وعمليات البحث البسيطة
- مكون إضافي مرن + كثيف للمتجه: أضف بحثًا متجهًا إلى إعداد Elasticsearch الحالي لديك
لكلٍّ منهما مزاياه. فايس عالي الأداء ولكنه معقد. آنوي بسيط ولكنه أبطأ. اختر ما يناسب مرحلتك وأهدافك.
اختتام الأمر
أصبح البحث عن تشابه المتجهات جزءًا أساسيًا من كيفية فهم الأنظمة الحديثة للبيانات. فهو ما يُمكّن التطبيقات وأدوات الذكاء الاصطناعي من تجاوز المطابقة السطحية وتفسير المعنى والسلوك والسياق بشكل فعلي.
بالتأكيد، قد تكون الحسابات وراء ذلك معقدة، لكن ثمارها عظيمة. سواء كنت تُنشئ محرك بحث، أو نظام توصيات، أو تحاول فقط فهم بياناتك المتزايدة، فإن تعلم كيفية العمل مع المتجهات سيفتح لك آفاقًا جديدة من النتائج الأذكى والأكثر سهولة في الاستخدام.
التعليمات
ما الذي يجعل البحث عن تشابه المتجهات مختلفًا عن البحث عن الكلمات الرئيسية؟
يكمن الاختلاف الرئيسي في كيفية فهم البيانات. يبحث البحث عن الكلمات الرئيسية عن تطابقات نصية دقيقة أو شبه دقيقة. أما البحث عن تشابه المتجهات، فيبحث عن المعنى، ويقارن المحتوى بناءً على مدى تشابهه في السياق، وليس فقط من حيث تطابق الكلمات.
هل يتم استخدام البحث عن تشابه المتجهات فقط في تطبيقات الذكاء الاصطناعي؟
إطلاقًا. مع شيوعه في الأنظمة التي تعمل بالذكاء الاصطناعي، ستجده أيضًا في محركات البحث، ومنصات التوصية، وأدوات كشف الاحتيال، وحتى في بعض لوحات معلومات المؤسسات. في أي مكان يكون فيه "العثور على عناصر متشابهة" أمرًا مهمًا، يكون للبحث المتجهي دورٌ فيه.
كيف يمكنني معرفة مقياس المسافة الذي يجب استخدامه؟
لا توجد إجابة واحدة تناسب الجميع. يعتمد الأمر على بياناتك. بالنسبة للنصوص، عادةً ما يكون تشابه جيب التمام فعالاً. أما بالنسبة للبيانات العددية أو الهندسية، فقد يكون الإقليدي أفضل. إذا كنت تعمل مع مجموعات أو خصائص ثنائية، فقد تفكر في استخدام جاكارد أو هامينغ. أفضل طريقة هي اختبار عدد قليل منها ومعرفة أيها يتوافق مع تعريف المستخدمين لكلمة "متشابه".“
Ready to stop rebuilding and start shipping?
Most of our engagements start with a single conversation about where your current team is stuck. No pitch deck, no obligations.


