
Nachricht
Grundlegendes zur Vektorähnlichkeitssuche und ihrer Funktionsweise
Haben Sie sich schon einmal gefragt, wie Ihre Lieblings-App das Gesuchte findet, selbst wenn Sie es nicht perfekt eingeben? Wenn Sie nach einem Bild, einem Lied oder einem Produkt suchen, das etwas ähnelt, das Ihnen schon einmal gefallen hat, liegt das oft an der Vektorähnlichkeitssuche, die im Hintergrund läuft. Dabei werden keine Wörter oder Dateinamen abgeglichen. Es geht darum, Muster zu erkennen – Beziehungen, die in Zahlen, Formen und Datenpunkten verborgen sind und Dinge auf subtile Weise miteinander verknüpfen.
Diese Technik steckt in vielen Bereichen, von Empfehlungssystemen bis hin zu KI-Chatbots. Aber was passiert dabei eigentlich? Wie finden Computer heraus, was “ähnlich” bedeutet, wenn es keine exakten Übereinstimmungen gibt? Wir erklären es Ihnen im Klartext und sehen uns an, wie es in der Praxis funktioniert.
Was ist eine Vektorähnlichkeitssuche?
Im Kern hilft die Vektorähnlichkeitssuche dabei, Elemente zu finden, die mathematisch dem gesuchten Objekt nahe kommen. Anstatt exakte Wörter oder Bezeichnungen abzugleichen, werden Beziehungen anhand von Mustern in den Daten selbst ermittelt. So kann ein System ein Foto erkennen, das einem anderen ähnelt, passende Songs empfehlen oder ein Dokument aufrufen, das die gleiche Bedeutung wie Ihre Suchanfrage hat.
Hier ist das große Ganze: Zunächst werden Ihre Rohdaten – ob Text, Bild oder Klick – in einen Vektor umgewandelt, im Grunde eine Zahlenliste, die die wichtigsten Merkmale darstellt. Bei der Suche wird Ihre Abfrage dann in einen weiteren Vektor umgewandelt. Schließlich vergleicht das System Ihren Vektor mit Millionen anderer und sucht nach denen, die am nächsten beieinander liegen. Je näher sie beieinander liegen, desto ähnlicher werden sie eingeschätzt. Eine einfache Idee, aber überraschend wirkungsvoll.
Was ist also überhaupt ein Vektor?
Ein Vektor ist eigentlich nur eine Liste von Zahlen. Doch in diesem Fall erfassen diese Zahlen die “Essenz” eines Objekts – seine Bedeutung, seinen Stil oder seine Eigenschaften – über viele Dimensionen hinweg. Ein Satz könnte zu einem 768-dimensionalen Vektor werden (wenn Sie ein Modell wie BERT verwenden). Ein Bild könnte 512 Dimensionen haben. Jede Zahl trägt dazu bei, einen winzigen Teil dessen zu beschreiben, was das Objekt einzigartig macht.
Alle diese Vektoren befinden sich in einem sogenannten hochdimensionalen Raum. Wenn wir zwei Elemente vergleichen, fragen wir uns im Grunde: Wie weit sind sie in diesem Raum voneinander entfernt? Je näher ihre Koordinaten beieinander liegen, desto ähnlicher sind sie sich.
Alles beginnt mit Einbettungen
Bevor ein Vergleich stattfinden kann, müssen die Daten in diese Vektoren konvertiert werden – ein Prozess, der als Einbettung bezeichnet wird. Verschiedene Modelle verarbeiten unterschiedliche Datentypen. Text wird von Modellen wie Word2Vec, GloVe oder BERT verarbeitet. Bilder durchlaufen Convolutional Neural Networks (CNNs). Strukturierte Daten können Feature Engineering oder Autoencoder verwenden.
Gute Einbettungen sind wie gute Übersetzungen: Sie erfassen das Wesentliche und ignorieren das Unwichtige. Wenn zwei Elemente wirklich ähnlich sind, liegen ihre Einbettungen nahe beieinander. Das ist die Magie hinter der ganzen Idee.
Wie wir die Vektorsuche aufbauen
Bei Mobian, Wir arbeiten mit Unternehmen zusammen, die nicht nur mit wachsenden Datenmengen, sondern auch mit zunehmender Komplexität zu kämpfen haben. Ob im Gesundheitswesen, im Finanzwesen, in der Telekommunikation oder in der Logistik – der Bedarf, relevante, kontextbezogene Informationen schnell zu finden, nimmt stetig zu. Genau hier kommt die Vektorähnlichkeitssuche ins Spiel.
Wenn wir Plattformen entwickeln oder Teams erweitern, unterstützen wir unsere Kunden oft dabei, über traditionelle Filterlogiken hinauszugehen und Systeme mit Einbettungen, intelligenter Indizierung und Echtzeit-Matching zu entwickeln. Ob wir die Suche in ein individuelles SaaS-Produkt integrieren oder ein KI-gestütztes Backend von Grund auf neu entwickeln – die Vektorsuche hilft uns, Erlebnisse zu schaffen, die intelligent, schnell und personalisiert wirken. Es geht nicht nur darum, Elemente abzugleichen. Es geht darum, Daten wirklich nutzbar zu machen – und dieser Herausforderung stellen wir uns.
Messung der “Nähe”
Um herauszufinden, welche Elemente ähnlich sind, messen Systeme den Abstand zwischen Vektoren. Verschiedene Abstandsmaße dienen unterschiedlichen Zwecken:
- Euklidische Distanz: Der geradlinige Weg zwischen zwei Punkten – einfach und intuitiv.
- Kosinus-Ähnlichkeit: Konzentriert sich auf den Winkel zwischen Vektoren und nicht auf die Entfernung. Ideal für Text.
- Jaccard-Ähnlichkeit: Betrachtet die Überschneidungen zwischen Sets, nützlich für Kategorien oder Tags.
- Manhattan-Entfernung: Addiert die Unterschiede Schritt für Schritt, als würden Sie Häuserblocks ablaufen.
- Hamming-Distanz: Zählt, wie viele Bits sich zwischen zwei binären Vektoren unterscheiden.
Keine Methode ist perfekt; es hängt davon ab, was “ähnlich” für Ihre Daten bedeutet.
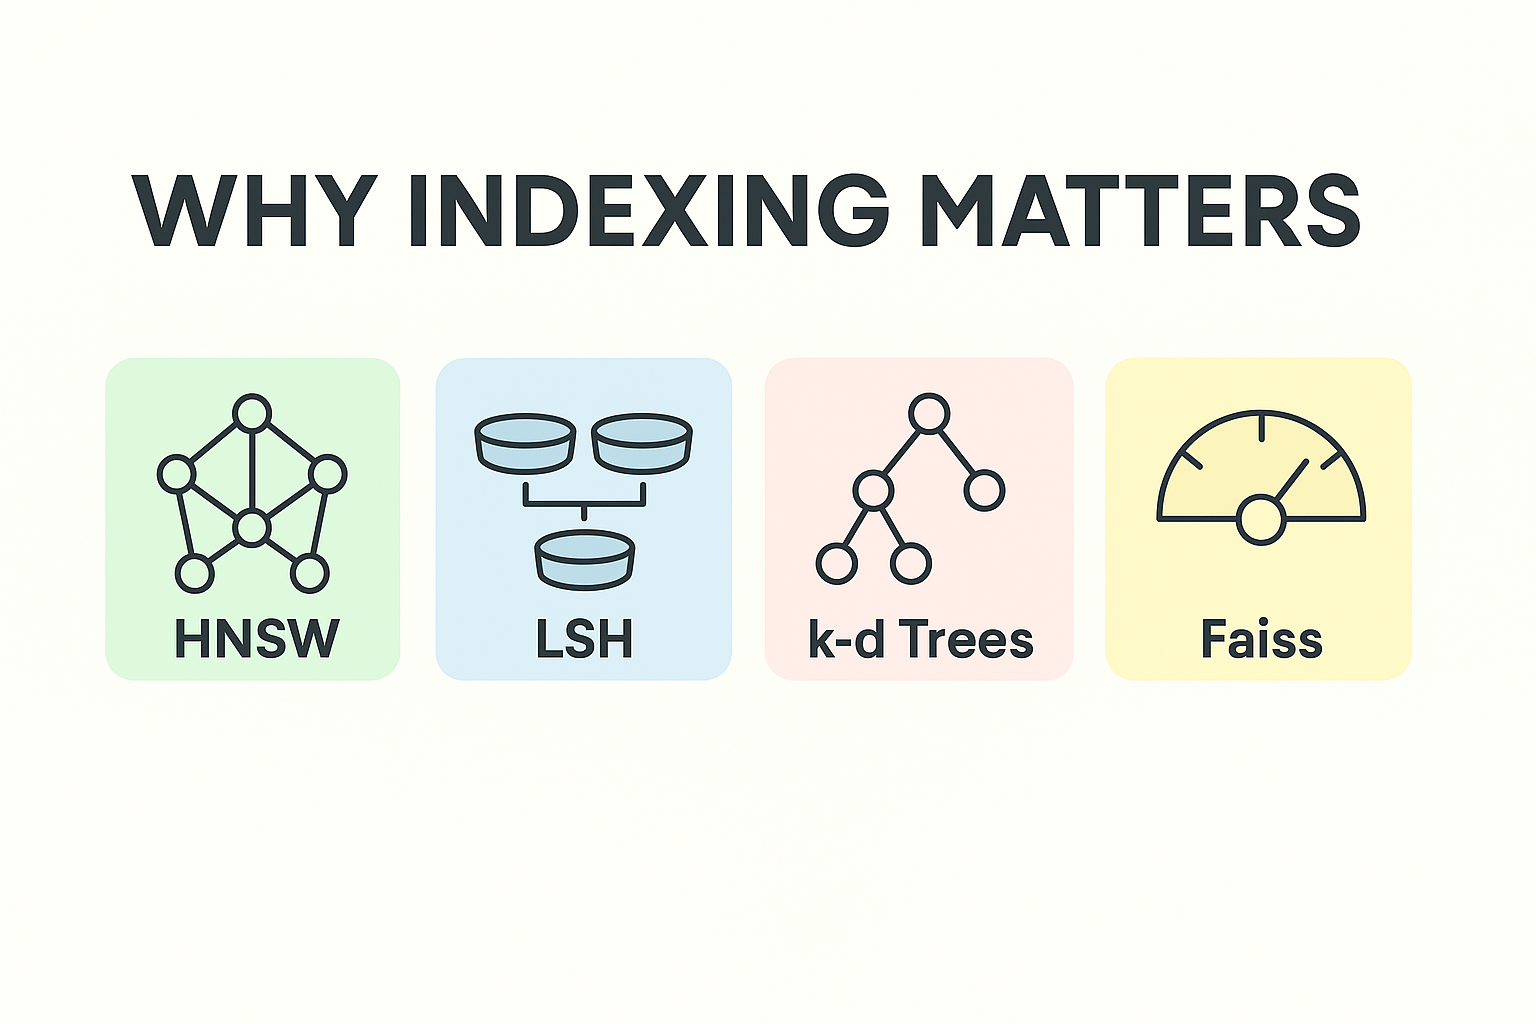
Warum die Indexierung wichtig ist
Wenn Sie nur ein paar Tausend Vektoren haben, reicht es vielleicht aus, sie alle einzeln zu vergleichen. Aber sobald Sie Millionen erreichen, scheitert dieser Ansatz. Die Indizierung hilft, indem sie die Vektoren organisiert, sodass die Suche nicht jeden einzelnen überprüfen muss.
Zu den gängigen Indexierungsmethoden gehören:
- HNSW: Ideal für schnelle, groß angelegte Näherungssuchen
- LSH: Gruppiert ähnliche Vektoren in Buckets für schnelle Nachschlagevorgänge
- kd-Bäume, Ballbäume: Funktionieren gut mit Daten mit niedrigerer Dimension
- Faiss, Annoy, VP Trees: Optimiert für Geschwindigkeit im großen Maßstab
Sie sind nicht immer perfekt, aber sie bringen Sie nah genug heran und das schnell.
Es richtig machen
Die Vektorsuche ist nichts, was man einfach einsteckt und fertig ist. Sie erfordert Planung und Feinabstimmung. Ein paar wichtige Punkte sind zu beachten:
- Datennormalisierung: Stellen Sie sicher, dass Ihre Daten vor dem Einbetten sauber und konsistent sind.
- Algorithmus-Tuning: Standardeinstellungen funktionieren selten in jedem Fall. Testen und optimieren Sie.
- Dimensionsreduzierung: Hochdimensionale Vektoren verlangsamen die Arbeit. Komprimieren Sie sie daher vorsichtig mit Tools wie PCA oder Autoencodern.
- Sharding und Parallelität: Teilen Sie große Datensätze in Blöcke auf und durchsuchen Sie sie parallel über alle Knoten hinweg.
- Hardwarebeschleunigung: Verwenden Sie GPUs oder TPUs, wenn es wirklich auf Geschwindigkeit ankommt.
Es ist wie beim Kochen – man kann die Zutaten nicht einfach zusammenwerfen. Die Vorbereitung ist entscheidend für das Gericht.
Wo Sie es in Aktion sehen werden
Sie haben die Vektorsuche wahrscheinlich schon einmal verwendet, ohne es zu merken. Sie steckt hinter visuellen Suchmaschinen, die Bilder nach Inhalt und nicht nach Dateinamen finden. Sie steckt in den Empfehlungen von Netflix oder Spotify, die Sie einfach packen. Sie unterstützt die Betrugserkennung, indem sie Transaktionen erkennt, die im Vergleich zu früheren Verhaltensweisen verdächtig erscheinen.
Sogar KI-Chatbots basieren darauf. Anstatt Schlüsselwörter abzugleichen, verwenden sie Einbettungen, um zu verstehen, was Sie meinen, und antworten mit einer relevanten Antwort. Und die semantische Suche – die intelligentere Art, die Ihre Absicht versteht – basiert auf demselben Prinzip.
Die Kompromisse
Die Vektorähnlichkeitssuche ist unglaublich nützlich, aber nicht ohne Probleme. Wie bei jedem komplexen System gibt es ein paar Eigenheiten, die Sie verstehen sollten, bevor Sie loslegen.
Da ist zunächst das Problem der hohen Dimensionen. Je mehr Dimensionen Ihre Vektoren haben, desto schwieriger wird es zu erkennen, was wirklich “nah” ist. In wirklich großen Räumen sieht alles gleich weit voneinander entfernt aus, was Ähnlichkeiten weniger bedeutsam macht. Es ist ein bisschen so, als würde man versuchen, seinen Freund in einer Menschenmenge zu entdecken – zu viele Richtungen, und plötzlich bedeutet “in der Nähe” nicht mehr viel.
Und dann ist da noch der Speicherplatz. Vektoren benötigen viel Speicherplatz. Wenn Sie mit Millionen von Datenpunkten arbeiten, die jeweils durch Hunderte von Zahlen repräsentiert werden, kann Ihr Speicherbedarf schnell explodieren. Und es sind nicht nur die Vektoren selbst. Sie müssen auch Indexstrukturen, Diagramme und Metadaten verwalten, um die Suche zu beschleunigen. Das alles summiert sich.
Auch die Wahl der richtigen Metrik kann Sie ins Stolpern bringen. Kosinusähnlichkeit, euklidische Distanz und Jaccard – jede Methode misst “Nähe” etwas anders. Wählen Sie die falsche Methode, könnten Ihre Ergebnisse völlig falsch aussehen. Manchmal geht es weniger um Theorie als vielmehr darum, zu testen, welche Methode für Ihre spezifischen Daten tatsächlich sinnvoll ist.
Und natürlich gibt es Ausreißer – jene seltsamen Datenpunkte, die nicht ins Muster passen. Ein paar seltsame Vektoren mit Extremwerten können Ihre Ergebnisse verfälschen und Ihre Suche auf irrelevante Treffer lenken. Wenn Sie diese nicht richtig behandeln, kann Ihr gesamtes System unmerklich Junk-Ergebnisse liefern.
Dies ist jedoch kein absolutes Problem. Es sind einfach Kompromisse, die mit der Arbeit im großen Maßstab einhergehen. Sobald Sie verstehen, wie Sie diese durch bessere Einbettungen, Normalisierung und Feinabstimmung bewältigen können, wird die Vektorähnlichkeitssuche zu einem der leistungsstärksten Tools in Ihrem KI-Toolkit.
Tools zum Ausprobieren, wenn Sie bereit sind, Neues zu entdecken
Ein Großteil der Arbeit wurde bereits erledigt. Sie müssen Ihre eigene Vektorsuchmaschine nicht von Grund auf neu erstellen.
Bibliotheken und Frameworks
- Faiss (Meta): Leistungsstark, schnell, GPU-fähig
- Annoy (Spotify): Ideal für die ungefähre Suche mit großen Datensätzen
- Milvus: Open-Source-Vektordatenbank mit integrierter Skalierbarkeit
- Scikit-learn: Gut für Prototyping und einfache Suchen
- Elastic + Dense Vector Plugin: Fügen Sie Ihrem vorhandenen Elasticsearch-Setup die Vektorsuche hinzu
Jede Variante hat ihre Vor- und Nachteile. Faiss ist leistungsstark, aber komplex. Annoy ist einfach, aber langsamer. Wählen Sie die Variante, die zu Ihrem Stadium und Ihren Zielen passt.
Zusammenfassung
Die Vektorähnlichkeitssuche wird zu einem zentralen Bestandteil des Datenverständnisses moderner Systeme. Sie ermöglicht Apps und KI-Tools, über oberflächliche Übereinstimmungen hinauszugehen und Bedeutung, Verhalten und Kontext tatsächlich zu interpretieren.
Sicher, die Mathematik dahinter kann knifflig sein, aber der Nutzen ist enorm. Egal, ob Sie eine Suchmaschine oder ein Empfehlungssystem entwickeln oder einfach nur versuchen, Ihre wachsenden Datenmengen zu verstehen: Wenn Sie lernen, mit Vektoren zu arbeiten, eröffnen sich Ihnen völlig neue Möglichkeiten intelligenterer und intuitiverer Ergebnisse.
Häufig gestellte Fragen
Was unterscheidet die Vektorähnlichkeitssuche von der Stichwortsuche?
Der Hauptunterschied liegt in der Art und Weise, wie sie Daten interpretieren. Bei der Stichwortsuche wird nach exakten oder nahezu exakten Textübereinstimmungen gesucht. Bei der Vektorähnlichkeitssuche hingegen wird die Bedeutung berücksichtigt. Dabei werden Inhalte anhand ihrer Ähnlichkeit im Kontext verglichen, nicht nur anhand der übereinstimmenden Wörter.
Wird die Vektorähnlichkeitssuche nur in KI-Anwendungen verwendet?
Ganz und gar nicht. Die Vektorsuche ist zwar in KI-gestützten Systemen weit verbreitet, findet sich aber auch in Suchmaschinen, Empfehlungsplattformen, Betrugserkennungstools und sogar in einigen Unternehmens-Dashboards. Überall dort, wo es darauf ankommt, “Dinge zu finden, die sich ähnlich anfühlen”, spielt die Vektorsuche eine Rolle.
Woher weiß ich, welche Distanzmetrik ich verwenden soll?
Es gibt keine allgemeingültige Antwort. Es hängt von Ihren Daten ab. Für Text funktioniert die Kosinus-Ähnlichkeitstheorie in der Regel gut. Für numerische oder geometrische Daten ist die euklidische Theorie möglicherweise besser geeignet. Wenn Sie mit Mengen oder binären Merkmalen arbeiten, könnten Jaccard oder Hamming in Betracht gezogen werden. Am besten testen Sie einige Methoden und sehen, welche mit der Definition von “ähnlich” Ihrer Benutzer übereinstimmt.”
Ready to stop rebuilding and start shipping?
Most of our engagements start with a single conversation about where your current team is stuck. No pitch deck, no obligations.


