
Búsqueda semántica vs. búsqueda vectorial: qué las diferencia realmente
La diferencia real entre la búsqueda semántica y la vectorial: cómo funciona cada una y cuándo usarlas en IA, PLN y aplicaciones con grandes volúmenes de datos.
La tecnología de búsqueda ha recorrido un largo camino desde los tiempos de la coincidencia de palabras clave y la lógica booleana básica. Hoy, los sistemas que impulsan las experiencias de búsqueda modernas no se limitan a buscar las palabras que se han escrito: intentan averiguar qué se quería decir. Y hay dos tecnologías clave detrás de ese cambio: la búsqueda semántica y la búsqueda vectorial.
Suenan parecido. De hecho, mucha gente las confunde o da por hecho que son dos nombres para lo mismo. Pero no lo son. Funcionan de forma distinta, persiguen objetivos diferentes y, según el tipo de producto o sistema que se esté construyendo, una puede tener mucho más sentido que la otra.
Veamos qué es realmente cada uno de estos enfoques de búsqueda, cómo funcionan por dentro, cuándo conviene usar uno u otro y por qué la mejor respuesta puede ser combinarlos.
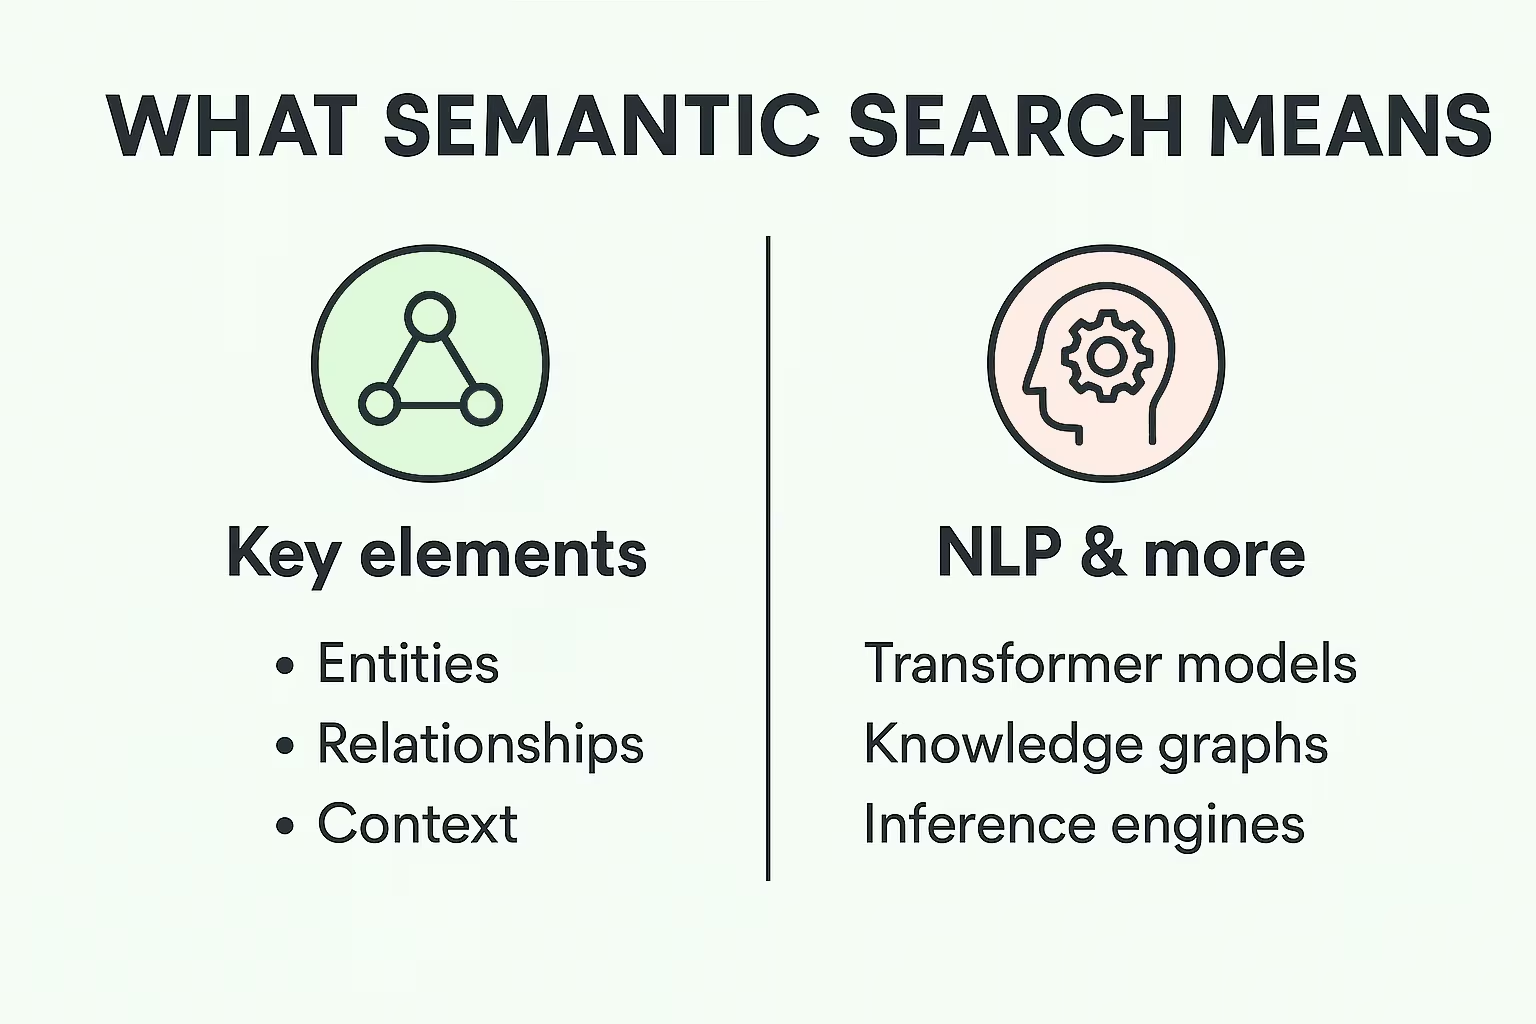
Qué entendemos realmente por «búsqueda semántica»
Empecemos por la idea de que la búsqueda puede entenderle. No sus palabras exactas, sino su intención.
La búsqueda semántica se basa en ese principio. Se centra en el significado de la consulta, no solo en las palabras concretas que se han utilizado. Si alguien busca «efectos secundarios de fumar», un buen motor de búsqueda semántica puede devolver documentos sobre «daño pulmonar», «riesgo cardiovascular» o incluso «humo de segunda mano», aunque esas expresiones no coincidan exactamente.
¿Y cómo funciona en realidad?
La búsqueda semántica utiliza el procesamiento del lenguaje natural (PLN) para descomponer la consulta e identificar:
- Las entidades clave (personas, lugares, temas)
- Las relaciones entre esas entidades
- El contexto (qué se pregunta y por qué)
En algunas configuraciones, los sistemas semánticos van aún más lejos y utilizan:
- Reconocimiento de entidades, para extraer nombres propios y términos propios del dominio
- Motores de inferencia, que intentan atar cabos y sacar a la luz conclusiones que el usuario no ha formulado de forma explícita
- Expansión del contexto, en la que el sistema incorpora términos o conceptos relacionados que sabe que son relevantes
Qué hace realmente la búsqueda vectorial
Hablemos ahora de la búsqueda vectorial. Aquí las cosas se vuelven más matemáticas.
En lugar de intentar comprender el lenguaje directamente, la búsqueda vectorial lo traduce todo a números. Utiliza modelos de embeddings para convertir palabras, frases, imágenes o incluso documentos completos en vectores, que son, básicamente, puntos en un espacio de muchas dimensiones. Los elementos con significados o características similares quedan situados más cerca unos de otros.
Así, cuando un usuario envía una consulta, el sistema no se limita a buscar palabras. También convierte la consulta en un vector y busca otros vectores cercanos. ¿Esos puntos cercanos? Son los resultados de la búsqueda.
Por dentro, suele funcionar así:
- Se crean embeddings con modelos como Word2Vec, GloVe o embeddings basados en transformers de OpenAI o HuggingFace
- Esos embeddings se almacenan en una base de datos vectorial (como Pinecone, Weaviate o pgvector)
- Se utiliza una métrica de distancia, como la similitud del coseno o la distancia euclidiana, para encontrar las coincidencias más cercanas
- Los resultados se ordenan según su proximidad en el espacio vectorial
Aquí es donde surge la confusión
Si a menudo se meten en el mismo saco es porque la búsqueda vectorial suele formar parte de la implementación de la búsqueda semántica. Es decir, los embeddings vectoriales pueden servir de base para captar el significado semántico. Es la técnica que hace posible el comportamiento semántico.
Pero la cosa no acaba ahí.
Mientras que la búsqueda vectorial ayuda a medir la similitud, la búsqueda semántica ayuda a entender la intención. Una es una herramienta; la otra, un objetivo.
Es perfectamente posible ejecutar una búsqueda vectorial sin entender en absoluto lo que quería decir el usuario. Y también se puede construir un sistema de búsqueda semántica que se apoye más en pipelines de PLN y grafos de conocimiento que en embeddings.
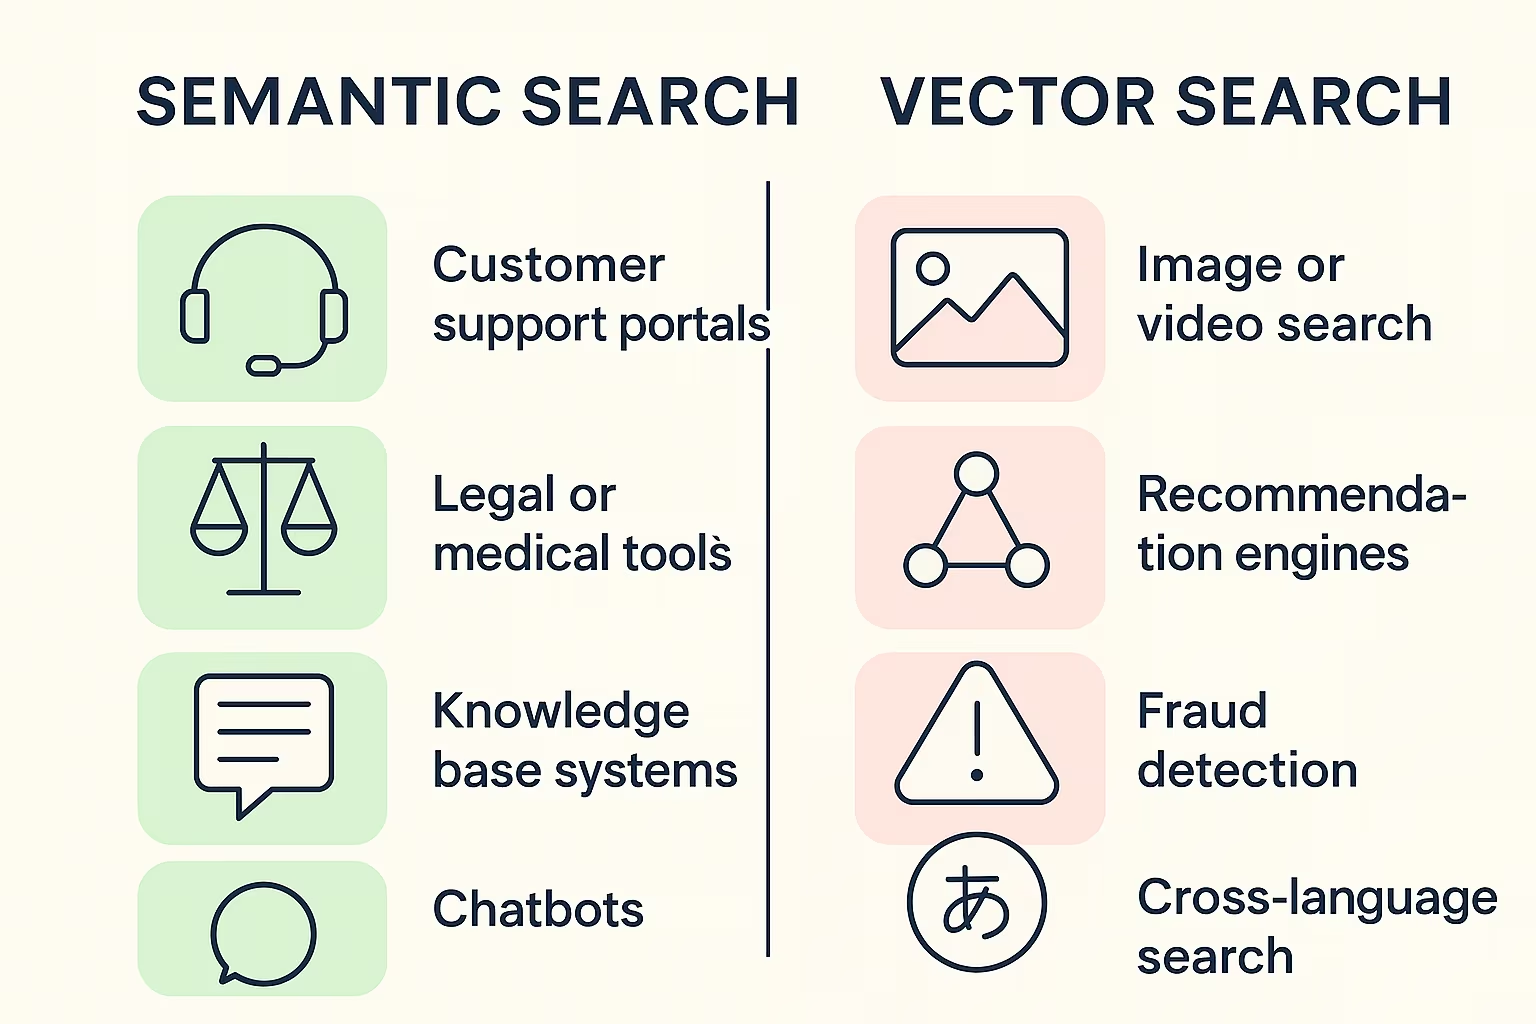
Casos de uso: cuándo tiene más sentido cada una
Aquí no hay un ganador universal. Cada enfoque destaca en escenarios distintos.
Cuándo funciona mejor la búsqueda semántica
La búsqueda semántica es adecuada cuando el sistema necesita interpretar el lenguaje con precisión, sobre todo si las consultas son ambiguas, están formuladas en lenguaje natural o tienen varias capas de significado.
Ejemplos:
- Portales de atención al cliente que deben responder preguntas cargadas de intención
- Herramientas de investigación jurídica o médica en las que la terminología no es homogénea
- Bases de conocimiento que deben «entender» el contexto de la pregunta del usuario
- Chatbots que deben responder con naturalidad a preguntas abiertas
Cuándo la búsqueda vectorial es la mejor opción
La búsqueda vectorial destaca cuando se trabaja con grandes volúmenes de datos no estructurados y lo que importa es la similitud, no la sintaxis.
Ejemplos:
- Búsqueda de imágenes o vídeos por similitud visual
- Motores de recomendación en tiempo real («a quienes les gustó esto también les gustó…»)
- Detección de fraude a partir de patrones en vectores de transacciones
- Búsqueda entre idiomas, donde la coincidencia literal de texto es imposible
Pero la verdad es que probablemente necesite ambas
Lo cierto es que la mayoría de los sistemas de búsqueda reales se benefician de combinar ambos enfoques. Muchos equipos están creando ya configuraciones híbridas que aúnan los puntos fuertes de la búsqueda vectorial y de la semántica. Normalmente, el proceso empieza con una búsqueda vectorial que recupera rápidamente los elementos más similares a partir de los embeddings. Después interviene una capa semántica que reordena esos resultados mediante procesamiento del lenguaje natural, reconocimiento de intención o incluso grafos de conocimiento, para ajustarlos mejor a lo que el usuario quería decir realmente. En algunos casos se añade también la coincidencia de palabras clave como alternativa de respaldo o como señal adicional. Esta combinación aporta a la vez velocidad y relevancia real, y hace que los resultados sean más rápidos y precisos.
Un pipeline híbrido básico podría ser así:
- Convertir todo el contenido en embeddings vectoriales y almacenarlos en una base de datos vectorial
- Indexar los metadatos y las palabras clave importantes para el enriquecimiento semántico
- Al recibir una consulta:
- Generar el embedding de la consulta y ejecutar una búsqueda rápida por similitud vectorial
- Pasar los mejores resultados por un reordenador semántico
- Aplicar los filtros propios del dominio o la lógica de negocio que corresponda
- Devolver los resultados finales combinados
Entre bastidores: las tecnologías clave
Repasemos brevemente los componentes principales de cada enfoque.
Qué puede utilizar la búsqueda semántica
La búsqueda semántica se basa en una combinación de herramientas y modelos centrados en el lenguaje. En su núcleo están los modelos de PLN como BERT o GPT, que ayudan al sistema a entender el texto más allá de las palabras literales. El proceso suele incluir la tokenización y el etiquetado gramatical para descomponer las frases e identificar la función de cada palabra. El reconocimiento de entidades sirve para identificar y clasificar elementos clave, como nombres, lugares o términos concretos. Los grafos de conocimiento entran en juego para trazar las relaciones entre conceptos y ayudan al sistema a conectar ideas que en apariencia no tienen relación. Algunas configuraciones incluyen también modelos de detección de intención para averiguar qué pregunta realmente el usuario, junto con motores de inferencia basados en reglas que aplican la lógica para descubrir significados más profundos.
Qué suele implicar la búsqueda vectorial
La búsqueda vectorial es más matemática y estructural. Empieza con la generación de embeddings mediante modelos como Word2Vec, CLIP o los embeddings de OpenAI, que convierten los datos en vectores numéricos. Estos vectores se almacenan y gestionan en bases de datos vectoriales específicas, como Weaviate, Pinecone, pgvector o FAISS. Para medir la similitud entre elementos, el sistema utiliza métricas de distancia como la similitud del coseno, el producto escalar o la distancia euclidiana. Por último, los algoritmos de vecinos más cercanos aproximados (ANN), como HNSW o IVF, permiten encontrar rápidamente los resultados más relevantes en grandes conjuntos de datos.
Qué tener en cuenta antes de elegir
La tecnología es fascinante, pero esto es lo que realmente importa a la hora de decidir qué usar.
| Factor | Búsqueda semántica | Búsqueda vectorial |
|---|---|---|
| Tipo de datos | Ideal para datos con mucho texto que dependen de la comprensión del lenguaje | Funciona mejor con datos multimodales, como texto, imágenes, audio o vídeo |
| Velocidad frente a precisión | Más lenta, pero ofrece resultados más precisos y sensibles al contexto | Extremadamente rápida y eficiente, sobre todo con grandes conjuntos de datos |
| Requisitos de cómputo | Exige una gran capacidad de procesamiento de PLN y modelos grandes (a menudo con GPU) | La generación de embeddings y el almacenamiento de vectores pueden consumir muchos recursos, pero son eficientes una vez implementados |
| Escala | Requiere una planificación y una arquitectura más cuidadosas para escalar con eficacia | Escala con facilidad a conjuntos de datos masivos, del orden de petabytes, gracias a las bases de datos vectoriales y los algoritmos ANN |
Cómo abordamos la búsqueda semántica y vectorial en Mobian
En Mobian no nos limitamos a seguir las tendencias de la IA: trabajamos con equipos que necesitan soluciones prácticas y escalables que resuelvan problemas reales. Por eso, para nosotros la diferencia entre búsqueda semántica y búsqueda vectorial no es solo teórica. Es algo que gestionamos a diario en las plataformas que construimos y escalamos para nuestros clientes.
Cuando desarrollamos productos que implican descubrimiento, personalización o búsqueda inteligente, planteamos estos sistemas desde la base. En aplicaciones con mucho contenido o plataformas de conocimiento, solemos apostar por técnicas semánticas para que los usuarios puedan preguntar con naturalidad y obtener respuestas con sentido sin tener que ser excesivamente concretos. En otros casos, sobre todo cuando intervienen la similitud o entradas multimodales, como en la búsqueda de vídeo o de imágenes, los métodos vectoriales son la columna vertebral del rendimiento. Y en muchos casos diseñamos arquitecturas de búsqueda híbridas para obtener lo mejor de ambos mundos.
Hemos comprobado de primera mano que un sistema de búsqueda solo funciona cuando está alineado con los objetivos a largo plazo del producto. Tanto si reforzamos un equipo de IA interno como si asumimos el desarrollo de ciclo completo, nuestro trabajo consiste en elegir el enfoque de búsqueda adecuado, integrarlo sin fricciones y mantenerlo flexible a medida que evoluciona el producto. Porque el verdadero reto no es solo elegir entre semántica o vectorial, sino construir algo que ofrezca resultados relevantes aunque los datos y las necesidades de los usuarios cambien con el tiempo.
En resumen
La búsqueda semántica y la búsqueda vectorial no son rivales. Son simplemente dos caminos distintos para llegar a una respuesta mejor, según el tipo de pregunta que se plantee. Una se apoya en el significado y el lenguaje; la otra, en las matemáticas y la similitud. Si está construyendo algo en lo que la gente confía para encontrar lo que necesita, de forma rápida, precisa y con todo tipo de datos, es muy probable que acabe utilizando ambas.
Al final, no se trata de elegir la herramienta de moda. Se trata de construir una búsqueda que se ajuste a sus usuarios, a sus datos y a la forma de su producto. Tanto si eso supone una capa de enriquecimiento semántico sobre un motor vectorial como un índice vectorial limpio que alimente una función de recomendación, lo importante es saber qué hace realmente cada pieza y por qué.
Los equipos que aciertan no son los que persiguen la moda del momento, sino los que se fijan en cómo busca la gente y en qué quiere decir realmente cuando lo hace.
Preguntas frecuentes
¿La búsqueda semántica es siempre más precisa que la búsqueda vectorial?
No necesariamente. La búsqueda semántica entiende mejor la intención del usuario y el lenguaje natural, pero la búsqueda vectorial es extraordinariamente buena detectando similitudes en conjuntos de datos grandes y no estructurados. Cada una resuelve una parte distinta del problema. De hecho, combinarlas suele dar resultados más equilibrados y precisos.
¿Puedo usar la búsqueda vectorial sin ningún componente semántico?
Sí. La búsqueda vectorial por sí sola no requiere comprender el lenguaje: solo necesita buenos embeddings y una métrica de distancia. Puede usarla para comparar imágenes, detectar anomalías o recomendar artículos a partir de la similitud de patrones, aunque no intervenga el lenguaje en absoluto.
¿Necesito un gran equipo de IA para implementar cualquiera de las dos?
Ya no. Hoy existen herramientas y frameworks que facilitan mucho empezar con la búsqueda semántica y con la vectorial. Aun así, sigue necesitando a alguien que sepa tomar buenas decisiones de arquitectura. Lo difícil no es construirla, sino construirla bien.
¿Alguna de las dos es mejor para aplicaciones RAG?
La mayoría de los pipelines de RAG (generación aumentada por recuperación) se apoyan en gran medida en la búsqueda vectorial para la fase de recuperación. Pero si quiere que la respuesta resulte coherente y relevante, las técnicas semánticas, sobre todo el reordenamiento (re-ranking) o la detección de intención, pueden afinar mucho los resultados antes de que lleguen al LLM.