
Noticias
Comprensión de la búsqueda por similitud vectorial y cómo funciona
¿Alguna vez te has preguntado cómo tu aplicación favorita parece captar lo que buscas, incluso cuando no lo escribes correctamente? Cuando buscas una imagen, una canción o un producto que se parece a algo que te gustaba antes, suele ser gracias a la búsqueda por similitud vectorial que funciona silenciosamente entre bastidores. No se trata de encontrar coincidencias de palabras o nombres de archivos. Se trata de reconocer patrones: relaciones ocultas en números, formas y puntos de datos que conectan una cosa con otra de forma sutil.
Esta técnica impulsa todo, desde sistemas de recomendación hasta chatbots de IA. Pero ¿qué ocurre realmente? ¿Cómo determinan las computadoras el significado de "similar" cuando no hay coincidencias exactas? Analicémoslo en términos sencillos y veamos cómo funciona en la vida real.
¿Qué es la búsqueda de similitud vectorial?
En esencia, la búsqueda por similitud vectorial ayuda a encontrar elementos matemáticamente similares a lo que buscas. En lugar de buscar palabras o etiquetas exactas, encuentra relaciones basadas en patrones en los propios datos. Así, un sistema puede reconocer una foto que se parece a otra, recomendar canciones que te gusten o encontrar un documento que significa lo mismo que tu consulta.
Aquí está el panorama general. Primero, tus datos sin procesar, ya sea texto, una imagen o incluso un clic, se convierten en un vector, básicamente una lista de números que representan sus características más importantes. Luego, al buscar, tu consulta se convierte en otro vector. Finalmente, el sistema compara tu vector con millones de otros y busca los que están más cerca. Cuanto más cerca estén, más similares se consideran. Una idea simple, pero sorprendentemente eficaz.
Entonces, ¿qué es un vector?
Un vector es simplemente una lista de números. Pero en este caso, esos números capturan la esencia de un objeto (su significado, estilo o características) en múltiples dimensiones. Una oración podría convertirse en un vector de 768 dimensiones (si se utiliza un modelo como BERT). Una imagen podría tener 512 dimensiones. Cada número ayuda a describir una pequeña parte de lo que hace único a ese objeto.
Todos esos vectores residen en lo que se denomina un espacio de alta dimensión. Al comparar dos elementos, básicamente nos preguntamos: ¿a qué distancia se encuentran en ese espacio? Cuanto más cercanas sean sus coordenadas, más parecidos serán.
Todo comienza con las incrustaciones
Antes de poder realizar la comparación, es necesario convertir los datos en esos vectores, un proceso denominado incrustación. Los distintos modelos gestionan distintos tipos de datos. El texto se procesa mediante modelos como Word2Vec, GloVe o BERT. Las imágenes se procesan mediante redes neuronales convolucionales (CNN). Los datos estructurados pueden utilizar ingeniería de características o autocodificadores.
Las buenas incrustaciones son como buenas traducciones: captan lo más importante e ignoran lo que no. Cuando dos elementos son genuinamente similares, sus incrustaciones terminan muy juntas. Esa es la magia detrás de todo el concepto.
Cómo construimos en torno a la búsqueda vectorial
En Mobian, Trabajamos con empresas que no solo gestionan un volumen creciente de datos, sino que también se enfrentan a una complejidad cada vez mayor. Ya sea en el sector sanitario, financiero, de telecomunicaciones o logístico, la necesidad de obtener rápidamente información relevante y contextualizada no hace más que aumentar. Ahí es precisamente donde la búsqueda por similitud vectorial resulta fundamental.
Al crear plataformas o ampliar equipos, solemos ayudar a nuestros clientes a ir más allá de la lógica de filtrado tradicional hacia sistemas que utilizan incrustaciones, indexación inteligente y coincidencias en tiempo real. Ya sea que integremos la búsqueda en un producto SaaS personalizado o construyamos un backend basado en IA desde cero, la búsqueda vectorial nos ayuda a crear experiencias inteligentes, rápidas y personalizadas. No se trata solo de encontrar coincidencias. Se trata de hacer que los datos sean realmente útiles, y ese es un reto que sabemos cómo afrontar.
Medición de la “cercanía”
Para determinar qué elementos son similares, los sistemas miden la distancia entre vectores. Las distintas métricas de distancia tienen distintas funciones:
- Distancia euclidiana: la trayectoria recta entre dos puntos: simple e intuitiva.
- Similitud de coseno: Se centra en el ángulo entre vectores, no en la distancia. Ideal para texto.
- Similitud Jaccard: analiza la superposición entre conjuntos, útil para categorías o etiquetas.
- Distancia de Manhattan: suma las diferencias paso a paso, como caminar cuadras de la ciudad.
- Distancia de Hamming: cuenta cuántos bits difieren entre dos vectores binarios.
Ningún método es perfecto; depende de lo que signifique “similar” para sus datos.
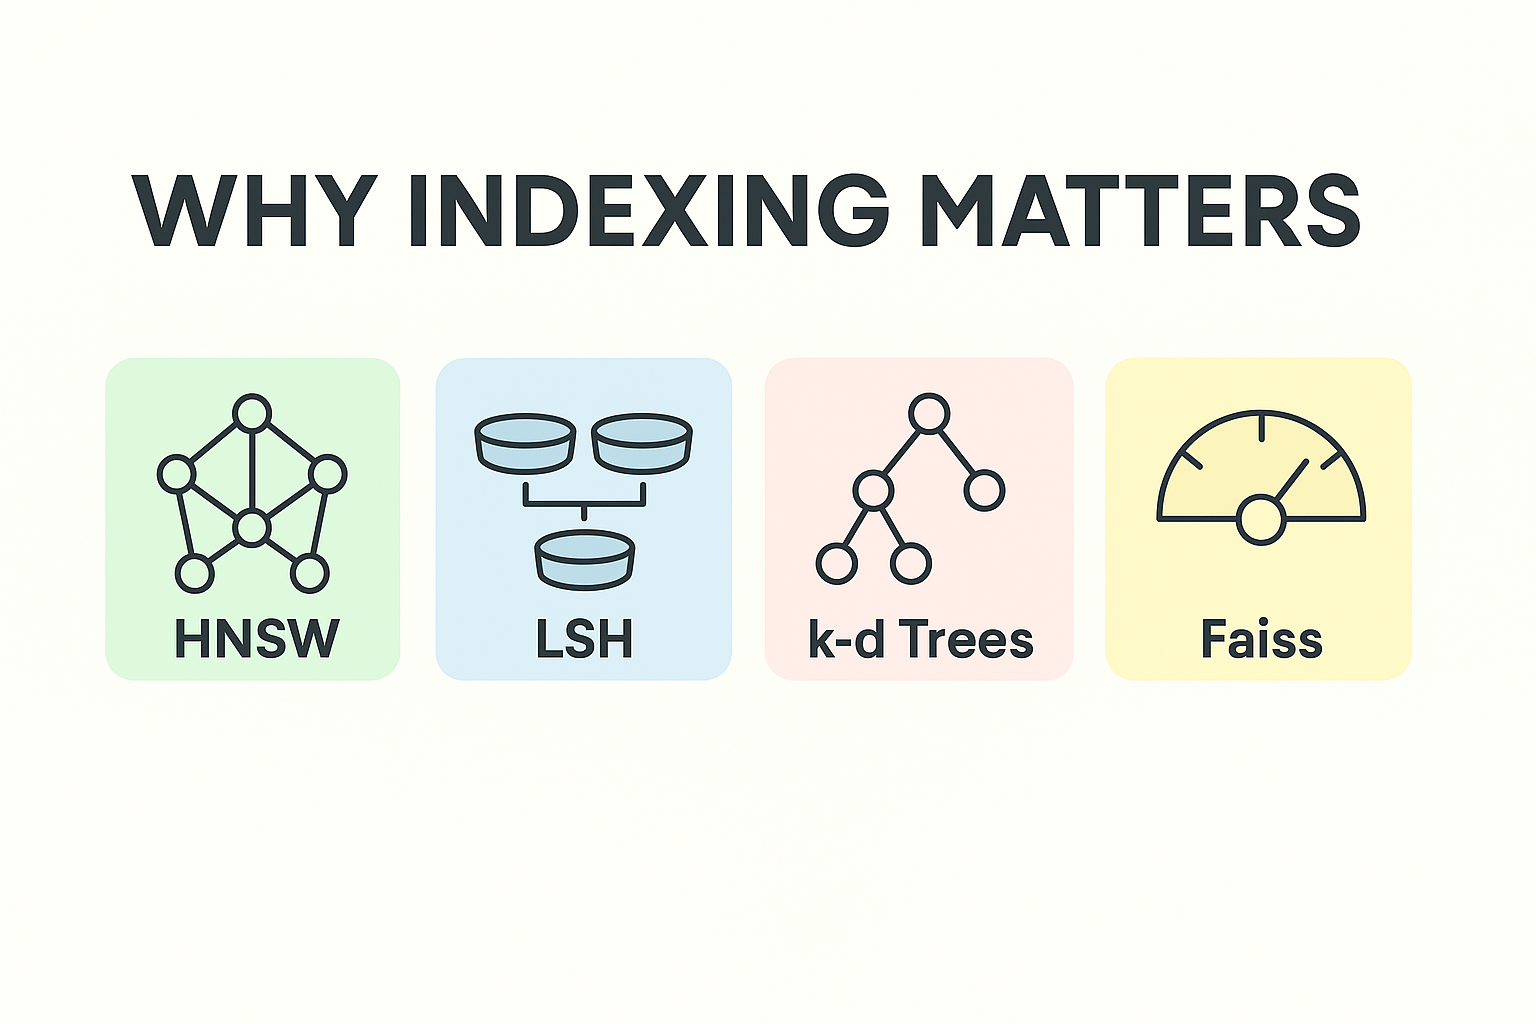
Por qué es importante la indexación
Si solo tienes unos pocos miles de vectores, compararlos uno por uno podría ser suficiente. Pero al llegar a millones, este enfoque se desmorona. La indexación ayuda a organizar los vectores para que la búsqueda no tenga que revisarlos todos.
Algunos métodos de indexación populares incluyen:
- HNSW: Ideal para búsquedas aproximadas rápidas y a gran escala
- LSH: Agrupa vectores similares en contenedores para búsquedas rápidas
- Árboles kd, árboles de bolas: funcionan bien con datos de menor dimensión
- Árboles Faiss, Annoy, VP: optimizados para la velocidad a gran escala
No siempre son perfectos, pero se acercan lo suficiente y lo hacen rápido.
Hacerlo bien
La búsqueda vectorial no es algo que se instala y listo. Requiere planificación y ajustes. Algunos aspectos importantes a considerar:
- Normalización de datos: asegúrese de que sus datos estén limpios y sean consistentes antes de integrarlos.
- Ajuste del algoritmo: La configuración predeterminada rara vez funciona en todos los casos. Pruebe y ajuste.
- Reducción de dimensionalidad: los vectores de alta dimensión ralentizan los procesos, por lo que es necesario comprimirlos con cuidado utilizando herramientas como PCA o autocodificadores.
- Fragmentación y paralelismo: para conjuntos de datos grandes, divídalos en fragmentos y busque en los nodos en paralelo.
- Aceleración de hardware: utilice GPU o TPU cuando la velocidad realmente importa.
Es como cocinar: no se pueden mezclar los ingredientes. La preparación es clave para el éxito o el fracaso del plato.
Dónde lo verás en acción
Probablemente hayas usado la búsqueda vectorial sin darte cuenta. Está detrás de los motores de búsqueda visuales que encuentran imágenes por contenido, no por nombre de archivo. Está en las recomendaciones de Netflix o Spotify que te atrapan. Potencia la detección de fraudes al detectar transacciones que parecen extrañas en comparación con comportamientos anteriores.
Incluso los chatbots de IA dependen de ello. En lugar de buscar palabras clave, utilizan incrustaciones para comprender lo que quieres decir y responder con algo relevante. Y la búsqueda semántica (la más inteligente que comprende tu intención) se basa en el mismo principio.
Las compensaciones
La búsqueda por similitud vectorial es increíblemente útil, pero no está exenta de complicaciones. Como cualquier sistema complejo, existen algunas peculiaridades que conviene comprender antes de empezar.
En primer lugar, está el problema de las altas dimensiones. Cuantas más dimensiones tengan los vectores, más difícil será distinguir qué está realmente "cerca". En espacios muy grandes, todo empieza a parecer igualmente distante, lo que hace que la similitud sea menos significativa. Es como intentar localizar a tu amigo entre miles de personas: hay demasiadas direcciones para mirar, y de repente, "cerca" ya no significa mucho.
Luego está el almacenamiento. Los vectores ocupan mucho espacio. Al trabajar con millones de puntos de datos, cada uno representado por cientos de números, las necesidades de almacenamiento y memoria pueden aumentar rápidamente. No se trata solo de los vectores en sí. También se mantienen estructuras de indexación, gráficos y metadatos para agilizar la búsqueda. Todo suma.
Elegir la métrica correcta también puede ser un error. La similitud del coseno, la distancia euclidiana y Jaccard miden la "cercanía" de forma ligeramente diferente. Si eliges la incorrecta, tus resultados podrían ser completamente erróneos. A veces, se trata menos de teoría y más de comprobar qué método es realmente adecuado para tus datos específicos.
Y, por supuesto, existen valores atípicos: esos datos inusuales que no se ajustan al patrón. Unos pocos vectores inusuales con valores extremos pueden distorsionar los resultados, llevando la búsqueda hacia coincidencias irrelevantes. Si no se gestionan correctamente, todo el sistema puede empezar a mostrar resultados basura sin que uno se dé cuenta.
Sin embargo, ninguno de estos factores es decisivo. Son simplemente las desventajas que conlleva trabajar a gran escala. Una vez que se comprende cómo gestionarlas, mediante mejores integraciones, normalización y ajustes, la búsqueda por similitud vectorial se convierte en una de las herramientas más potentes de la IA.
Herramientas para probar si estás listo para explorar
Ya se ha hecho mucho trabajo pesado. No necesitas crear tu propio motor de búsqueda vectorial desde cero.
Bibliotecas y marcos
- Faiss (Meta): Potente, rápido y compatible con GPU
- Molestar (Spotify): ideal para búsquedas aproximadas con grandes conjuntos de datos
- Milvus: base de datos vectorial de código abierto con escalabilidad integrada
- Scikit-learn: ideal para creación de prototipos y búsquedas sencillas
- Complemento Elastic + Dense Vector: agregue la búsqueda vectorial a su configuración existente de Elasticsearch
Cada una tiene sus desventajas. Faiss ofrece un alto rendimiento, pero es compleja. Annoying es simple, pero más lenta. Elige la que se adapte a tu etapa y objetivos.
Envolviéndolo
La búsqueda por similitud vectorial se está convirtiendo en un componente fundamental de la comprensión de los datos por parte de los sistemas modernos. Es lo que permite a las aplicaciones y herramientas de IA ir más allá de la coincidencia superficial e interpretar realmente el significado, el comportamiento y el contexto.
Claro, las matemáticas pueden ser complicadas, pero la recompensa es enorme. Ya sea que estés creando un motor de búsqueda, un sistema de recomendación o simplemente intentando comprender tus crecientes datos, aprender a trabajar con vectores te abrirá un mundo completamente nuevo de resultados más inteligentes e intuitivos.
Preguntas frecuentes
¿Qué hace que la búsqueda por similitud de vectores sea diferente de la búsqueda por palabras clave?
La principal diferencia radica en cómo interpretan los datos. La búsqueda por palabras clave busca coincidencias textuales exactas o casi exactas. La búsqueda por similitud vectorial, en cambio, analiza el significado. Compara el contenido en función de su similitud en el contexto, no solo en términos de coincidencia de palabras.
¿La búsqueda de similitud vectorial solo se utiliza en aplicaciones de IA?
Para nada. Si bien es popular en sistemas basados en IA, también se encuentra en motores de búsqueda, plataformas de recomendación, herramientas de detección de fraude e incluso en algunos paneles empresariales. Donde sea importante encontrar elementos similares, la búsqueda vectorial es fundamental.
¿Cómo sé qué métrica de distancia utilizar?
No existe una solución universal. Depende de los datos. Para texto, la similitud de coseno suele funcionar bien. Para datos numéricos o geométricos, la ecuación euclidiana podría ser mejor. Si trabaja con conjuntos o características binarias, podría considerar Jaccard o Hamming. El mejor enfoque es probar varias y ver cuál se ajusta a la definición de "similar" de sus usuarios.“
Ready to stop rebuilding and start shipping?
Most of our engagements start with a single conversation about where your current team is stuck. No pitch deck, no obligations.


