
Recherche sémantique vs recherche vectorielle : ce qui les distingue vraiment
Recherche sémantique ou recherche vectorielle : la vraie différence, leur fonctionnement et quand les utiliser en IA, en NLP et sur de gros volumes de données.
Les technologies de recherche ont parcouru un long chemin depuis l’époque de la correspondance par mots-clés et de la logique booléenne élémentaire. Aujourd’hui, les systèmes qui animent les expériences de recherche modernes ne se contentent pas de chercher les mots que vous avez tapés : ils tentent de comprendre ce que vous vouliez dire. Et deux technologies clés sont à l’origine de cette évolution : la recherche sémantique et la recherche vectorielle.
Leurs noms se ressemblent. Beaucoup les confondent d’ailleurs, ou pensent qu’il s’agit de deux noms pour une même chose. Ce n’est pas le cas. Elles fonctionnent différemment, poursuivent des objectifs différents et, selon le produit ou le système que vous construisez, l’une peut s’avérer bien plus pertinente que l’autre.
Voyons ce que recouvre réellement chacune de ces approches, comment elles fonctionnent en coulisses, quand privilégier l’une plutôt que l’autre et pourquoi la meilleure réponse consiste peut-être à les combiner.
Ce que l’on entend vraiment par « recherche sémantique »
Partons de l’idée qu’un moteur de recherche peut vous comprendre. Pas vos mots exacts, mais votre intention.
La recherche sémantique repose sur ce principe. Elle s’intéresse au sens de votre requête, et pas seulement aux termes précis que vous avez employés. Si quelqu’un cherche « effets secondaires du tabac », un bon moteur de recherche sémantique pourra renvoyer des documents sur les « lésions pulmonaires », le « risque cardiovasculaire » ou même le « tabagisme passif », alors que ces expressions ne correspondent pas exactement à la requête.
Comment cela fonctionne-t-il concrètement ?
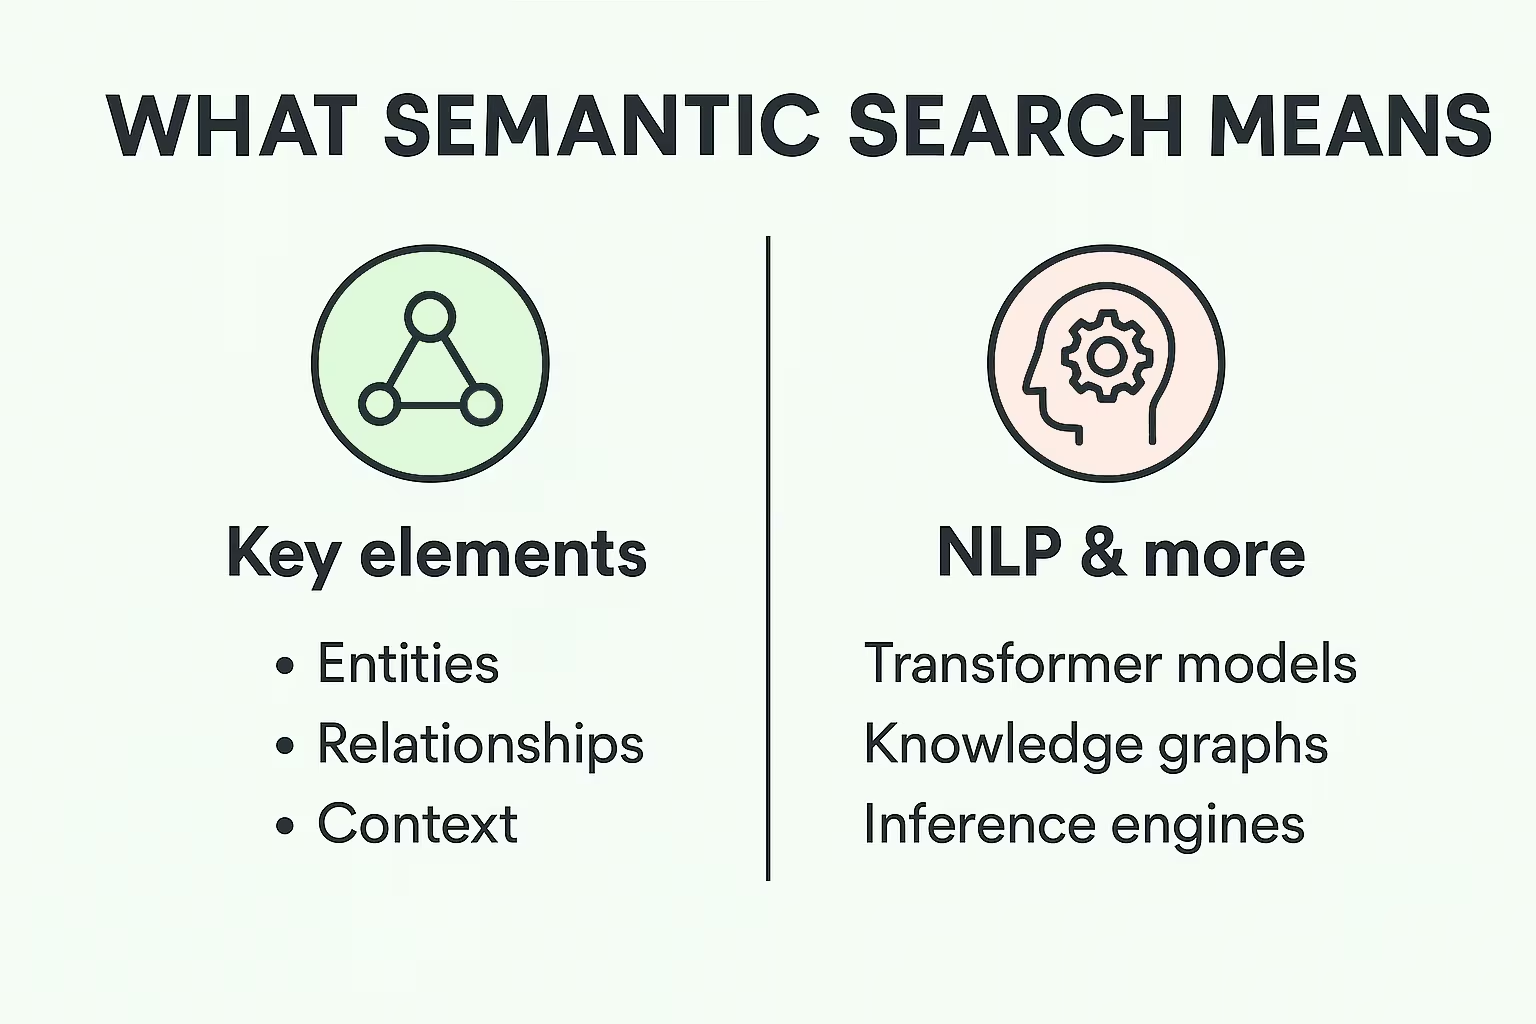
La recherche sémantique utilise le traitement automatique du langage naturel (NLP) pour décomposer une requête et identifier :
- Les entités clés (personnes, lieux, sujets)
- Les relations entre ces entités
- Le contexte (ce qui est demandé, et pourquoi)
Dans certaines configurations, les systèmes sémantiques vont encore plus loin en s’appuyant sur :
- La reconnaissance d’entités, pour extraire les noms propres et les termes propres à un domaine
- Des moteurs d’inférence, qui tentent de relier les éléments entre eux et de faire émerger des conclusions que l’utilisateur n’a pas formulées explicitement
- L’expansion de contexte, par laquelle le système ajoute des termes ou des concepts associés qu’il sait pertinents
Ce que fait vraiment la recherche vectorielle
Passons maintenant à la recherche vectorielle. C’est là que les choses deviennent plus mathématiques.
Au lieu de chercher à comprendre directement le langage, la recherche vectorielle traduit tout en nombres. Elle utilise des modèles d’embedding pour transformer des mots, des phrases, des images, voire des documents entiers, en vecteurs, c’est-à-dire en points dans un espace de grande dimension. Les éléments dont le sens ou les caractéristiques se ressemblent se retrouvent plus proches les uns des autres.
Ainsi, lorsqu’un utilisateur soumet une requête, le système ne se contente pas de rechercher des mots. Il convertit lui aussi la requête en vecteur et cherche les autres vecteurs situés à proximité. Ces points voisins ? Ce sont vos résultats de recherche.
En coulisses, cela fonctionne généralement ainsi :
- Les embeddings sont créés à l’aide de modèles comme Word2Vec, GloVe ou des embeddings à base de transformers proposés par OpenAI ou HuggingFace
- Ces embeddings sont stockés dans une base de données vectorielle (comme Pinecone, Weaviate ou pgvector)
- Une métrique de distance, comme la similarité cosinus ou la distance euclidienne, sert à trouver les correspondances les plus proches
- Les résultats sont classés selon leur proximité dans l’espace vectoriel
C’est là que naît la confusion
Si on les met souvent dans le même sac, c’est parce que la recherche vectorielle fait souvent partie de la mise en œuvre de la recherche sémantique. Autrement dit, les embeddings vectoriels peuvent servir de base pour capturer le sens. C’est la technique qui produit le comportement sémantique.
Mais l’histoire ne s’arrête pas là.
La recherche vectorielle aide à mesurer la similarité, la recherche sémantique aide à comprendre l’intention. L’une est un outil, l’autre un objectif.
Il est tout à fait possible d’effectuer une recherche vectorielle sans véritable compréhension de ce que voulait dire l’utilisateur. Et l’on peut construire un système de recherche sémantique qui s’appuie davantage sur des pipelines NLP et des graphes de connaissances que sur des embeddings.
Cas d’usage : quand privilégier l’une ou l’autre
Il n’y a pas de vainqueur universel. Chaque approche brille dans des situations différentes.
Quand la recherche sémantique est la plus efficace
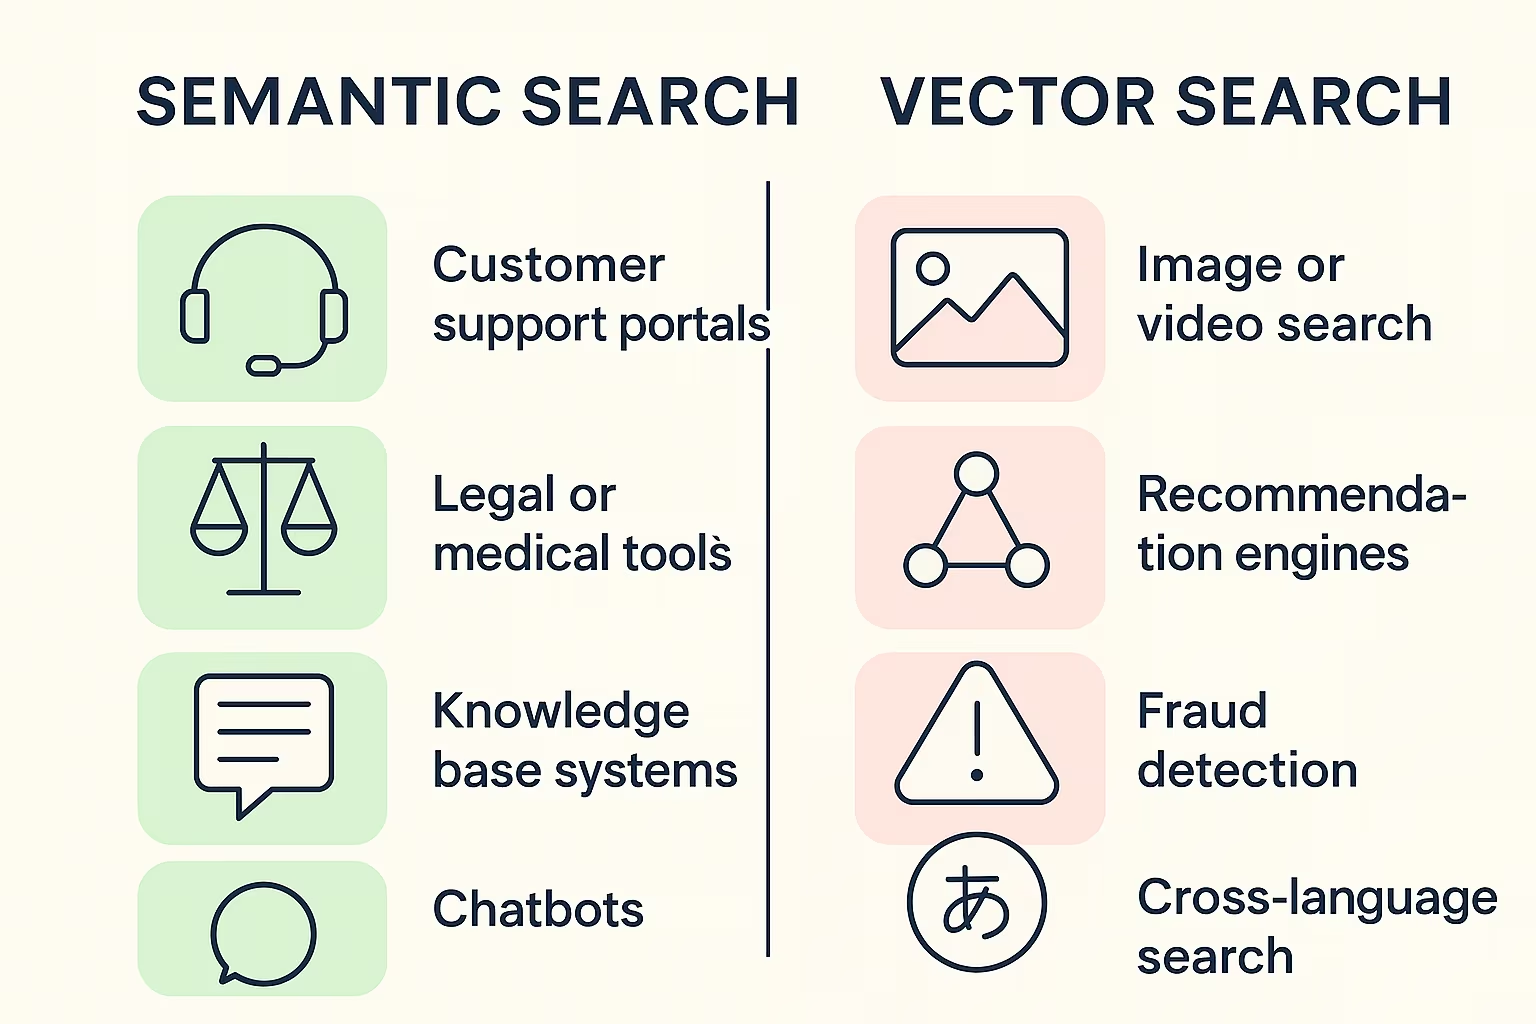
La recherche sémantique convient lorsque votre système doit interpréter le langage avec précision, en particulier lorsque les requêtes sont ambiguës, formulées en langage naturel ou porteuses de plusieurs niveaux de sens.
Exemples :
- Les portails de support client qui doivent répondre à des questions riches en intention
- Les outils de recherche juridique ou médicale, où la terminologie varie d’un document à l’autre
- Les bases de connaissances qui doivent « comprendre » le contexte de la question posée
- Les chatbots qui doivent répondre naturellement à des demandes ouvertes
Quand la recherche vectorielle est la meilleure option
La recherche vectorielle excelle lorsque vous traitez de grands volumes de données non structurées et que c’est la similarité qui compte, pas la syntaxe.
Exemples :
- La recherche d’images ou de vidéos fondée sur la similarité visuelle
- Les moteurs de recommandation en temps réel (« les personnes qui ont aimé ceci ont aussi aimé… »)
- La détection de fraude fondée sur les motifs repérés dans les vecteurs de transactions
- La recherche multilingue, lorsqu’une correspondance textuelle littérale est impossible
La vérité, c’est que vous avez probablement besoin des deux
En pratique, la plupart des systèmes de recherche réels gagnent à combiner les deux approches. De nombreuses équipes construisent désormais des architectures hybrides qui réunissent les atouts de la recherche vectorielle et de la recherche sémantique. En général, le processus commence par une recherche vectorielle qui récupère rapidement les éléments les plus similaires à partir des embeddings. Une couche sémantique prend ensuite le relais pour reclasser ces résultats à l’aide du traitement du langage naturel, de la reconnaissance d’intention, voire de graphes de connaissances, afin de mieux coller à ce que l’utilisateur voulait réellement dire. Dans certains cas, la correspondance par mots-clés est ajoutée en solution de repli ou comme signal supplémentaire. Cette combinaison offre à la fois rapidité et pertinence réelle : les résultats sont plus rapides et plus précis.
Un pipeline hybride simple peut ressembler à ceci :
- Convertir tout le contenu en embeddings vectoriels et le stocker dans une base de données vectorielle
- Indexer les métadonnées et mots-clés importants pour l’enrichissement sémantique
- À chaque requête :
- Calculer l’embedding de la requête et lancer une recherche rapide par similarité vectorielle
- Faire passer les meilleurs résultats par un reclasseur sémantique
- Appliquer les filtres métier ou la logique propre au domaine
- Renvoyer les résultats finaux combinés
Dans les coulisses : les technologies clés
Voici un bref aperçu des composants essentiels de chaque approche.
Ce que peut utiliser la recherche sémantique
La recherche sémantique repose sur une combinaison d’outils et de modèles centrés sur le langage. Au cœur du dispositif, des modèles de NLP comme BERT ou GPT aident le système à comprendre le texte au-delà des mots pris au pied de la lettre. Le processus comprend souvent la tokenisation et l’étiquetage morphosyntaxique, qui décomposent les phrases et identifient la fonction grammaticale des mots. La reconnaissance d’entités sert à identifier et à classer les éléments clés comme les noms, les lieux ou les termes spécifiques. Les graphes de connaissances interviennent pour cartographier les relations entre concepts et aider le système à relier des idées en apparence sans rapport. Certaines configurations intègrent aussi des modèles de détection d’intention pour déterminer ce que l’utilisateur demande réellement, ainsi que des moteurs d’inférence à base de règles qui appliquent une logique pour mettre au jour un sens plus profond.
Ce qu’implique généralement la recherche vectorielle
La recherche vectorielle est plus mathématique et plus structurée. Elle commence par la génération d’embeddings, à l’aide de modèles comme Word2Vec, CLIP ou les embeddings d’OpenAI, pour convertir les données en vecteurs numériques. Ces vecteurs sont ensuite stockés et gérés dans des bases de données vectorielles dédiées comme Weaviate, Pinecone, pgvector ou FAISS. Pour mesurer la similarité entre éléments, le système utilise des métriques de distance comme la similarité cosinus, le produit scalaire ou la distance euclidienne. Enfin, des algorithmes de recherche approximative des plus proches voisins (ANN), comme HNSW ou IVF, permettent de trouver rapidement les résultats les plus pertinents dans de grands ensembles de données.
Ce qu’il faut garder à l’esprit avant de choisir
La technologie est passionnante, mais voici ce qui compte vraiment au moment de choisir.
| Critère | Recherche sémantique | Recherche vectorielle |
|---|---|---|
| Type de données | Idéale pour les données principalement textuelles qui exigent une compréhension du langage | Plus adaptée aux données multimodales : texte, images, audio ou vidéo |
| Vitesse ou précision | Plus lente, mais fournit des résultats plus précis et tenant compte du contexte | Extrêmement rapide et efficace, en particulier sur de grands ensembles de données |
| Puissance de calcul | Exige une puissance de traitement NLP importante et de grands modèles (souvent sur GPU) | La génération d’embeddings et le stockage des vecteurs peuvent être gourmands en ressources, mais le système est efficace une fois en place |
| Montée en charge | Demande une planification et une architecture plus soignées pour passer à l’échelle | Passe facilement à l’échelle sur des ensembles de données massifs, de l’ordre du pétaoctet, grâce aux bases de données vectorielles et aux algorithmes ANN |
Notre approche de la recherche sémantique et vectorielle chez Mobian
Chez Mobian, nous ne nous contentons pas de suivre les tendances de l’IA : nous travaillons avec des équipes qui ont besoin de solutions concrètes et évolutives, capables de résoudre de vrais problèmes. C’est pourquoi la distinction entre recherche sémantique et recherche vectorielle n’a rien de théorique pour nous. C’est une question que nous traitons concrètement dans les plateformes que nous construisons et faisons évoluer pour nos clients.
Lorsque nous concevons des produits qui impliquent de la découverte, de la personnalisation ou de la recherche intelligente, nous pensons ces systèmes dès la base. Pour les applications riches en contenu ou les plateformes de connaissances, nous privilégions souvent les techniques sémantiques, afin que les utilisateurs puissent poser leurs questions naturellement et obtenir des réponses pertinentes sans devoir être trop précis. Dans d’autres cas, notamment lorsque la similarité ou des entrées multimodales entrent en jeu, comme pour la recherche de vidéos ou d’images, les méthodes vectorielles constituent l’épine dorsale des performances. Et souvent, nous concevons des architectures de recherche hybrides pour tirer le meilleur des deux mondes.
Nous avons constaté par nous-mêmes qu’un système de recherche ne fonctionne que s’il est aligné sur les objectifs à long terme du produit. Que nous renforcions une équipe IA interne ou que nous prenions en charge le développement de bout en bout, notre rôle est de choisir la bonne approche de recherche, de l’intégrer sans accroc et de la garder flexible à mesure que le produit évolue. Car le vrai défi ne consiste pas seulement à choisir entre sémantique et vectoriel : il s’agit de construire quelque chose qui produit des résultats pertinents, même lorsque les données et les besoins des utilisateurs évoluent.
Pour conclure
La recherche sémantique et la recherche vectorielle ne sont pas rivales. Ce sont simplement deux façons différentes d’obtenir une meilleure réponse, selon le type de question posée. L’une mise sur le sens et le langage, l’autre sur les mathématiques et la similarité. Si vous construisez un outil sur lequel les gens comptent pour trouver ce dont ils ont besoin, rapidement, avec précision et dans tous types de données, il y a de fortes chances que vous finissiez par utiliser les deux.
En fin de compte, il ne s’agit pas de choisir l’outil le plus à la mode, mais de construire une recherche adaptée à vos utilisateurs, à vos données et à la nature de votre produit. Qu’il s’agisse d’un enrichissement sémantique superposé à un moteur vectoriel ou d’un index vectoriel épuré au service d’une fonction de recommandation, l’essentiel est de savoir ce que fait réellement chaque brique, et pourquoi.
Les équipes qui réussissent ne sont pas celles qui courent après l’effet de mode. Ce sont celles qui prêtent attention à la façon dont les gens cherchent, et à ce qu’ils veulent vraiment dire quand ils le font.
Questions fréquentes
La recherche sémantique est-elle toujours plus précise que la recherche vectorielle ?
Pas forcément. La recherche sémantique comprend mieux l’intention de l’utilisateur et le langage naturel, mais la recherche vectorielle est redoutablement efficace pour repérer les similarités dans de grands ensembles de données non structurées. Elles résolvent des parties différentes du problème. En réalité, les combiner donne généralement des résultats plus équilibrés et plus précis.
Peut-on utiliser la recherche vectorielle sans aucune dimension sémantique ?
Oui. La recherche vectorielle seule ne nécessite aucune compréhension du langage : il lui faut simplement de bons embeddings et une métrique de distance. Vous pouvez l’utiliser pour associer des images, détecter des anomalies ou recommander des éléments sur la base de motifs similaires, même lorsque le langage n’intervient pas du tout.
Faut-il une grosse équipe IA pour mettre en œuvre l’une ou l’autre ?
Plus maintenant. Il existe aujourd’hui des outils et des frameworks qui facilitent grandement la prise en main de la recherche sémantique comme de la recherche vectorielle. Il vous faut tout de même quelqu’un capable de prendre les bonnes décisions d’architecture. Le plus difficile n’est pas de la construire, mais de bien la construire.
L’une des deux est-elle plus adaptée aux applications RAG ?
La plupart des pipelines RAG (génération augmentée par récupération) s’appuient largement sur la recherche vectorielle pour l’étape de récupération. Mais si vous voulez une réponse cohérente et pertinente, les techniques sémantiques, en particulier le reclassement (re-ranking) ou la détection d’intention, peuvent nettement affiner les résultats avant qu’ils n’atteignent le LLM.